楔子
一个人能能走的多远不在于他在顺境时能走的多快,而在于他在逆境时多久能找到曾经的自己。
历史
在计算机科学中,KMP 算法(Knuth–Morris–Pratt algorithm)可在一个字符串
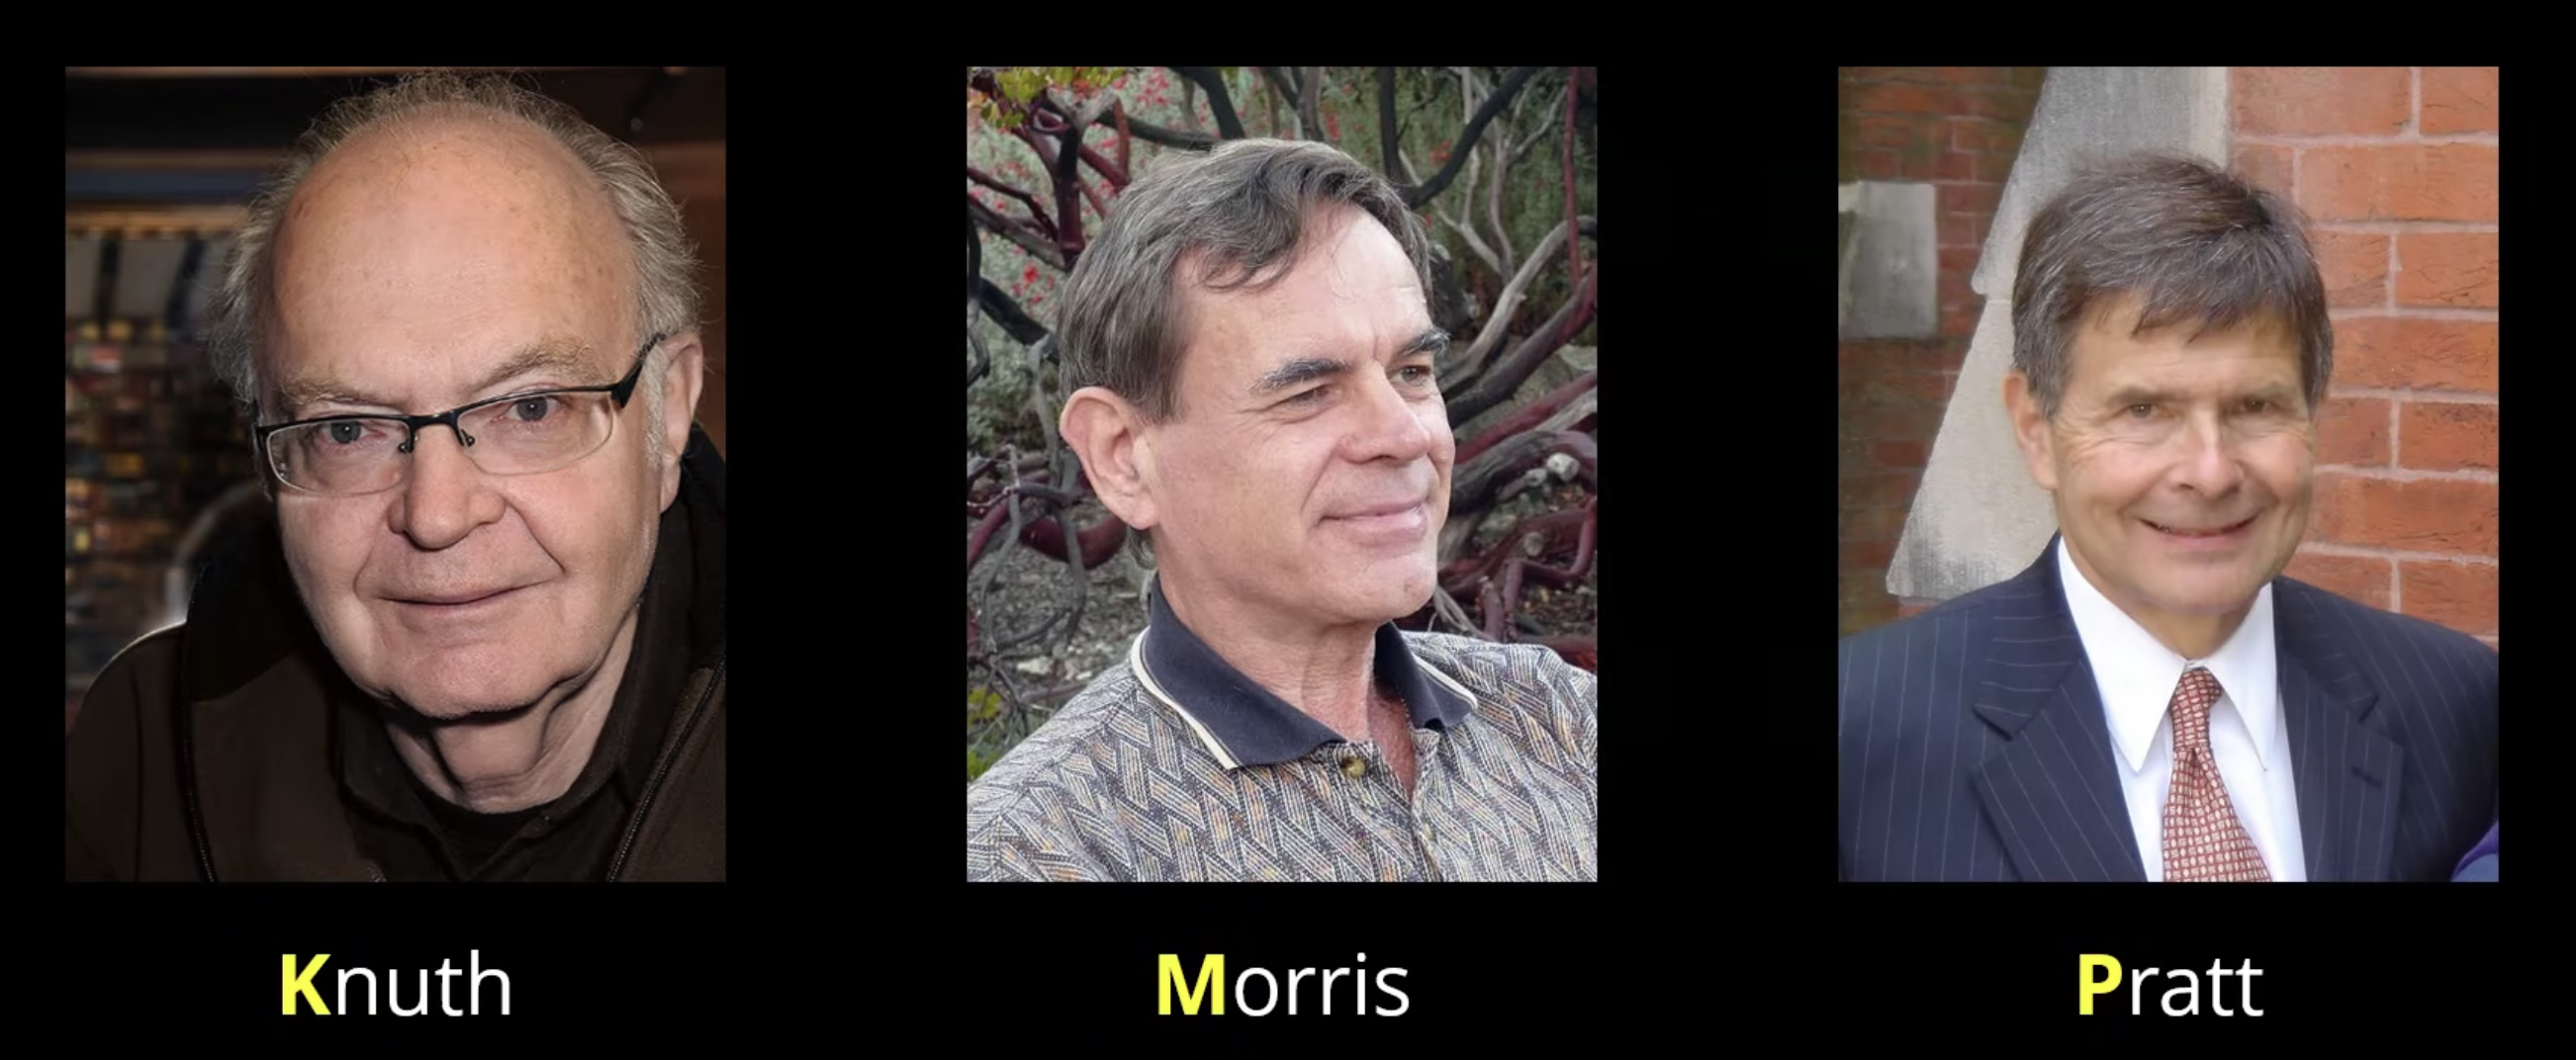 这个算法由 Donald Knuth 和 Vaughan Pratt 在1974年构思,同年 James H. Morris 也独立地设计出该算法,最终三人于1977年联合发表。
问题描述
给定主串(
和模式串(
请你在
也就是
示例 1:
输入:
= "sadbutsad", = "sad" 输出:0
解释:"sad" 在下标 0 和 6 处匹配。 第一个匹配项的下标是 0 ,所以返回 0 。
示例 2:
输入:
= "leetcode", = "leeto" 输出:-1
解释:"leeto" 没有在 "leetcode" 中出现,所以返回 -1 。
Brute Force
最直接、朴素的做法是在主串的每一个起始位置上都尝试一次。
假设当前从
S: · · · s[k] s[k+1] s[k+2] · · ·
P:       p[0] p[1]   p[2]   · · ·
如果字符相同,就同时向右移动:
如果在
对应代码就是:
class Solution {
public:
    int strStr(string s, string p) {
        int n = s.size(), m = p.size();
        for(int i = 0; i <= n - m; i++){
            int j = i, k = 0;
            while(k < m and s[j] == p[k]){
                j++;
                k++;
            }
            if(k == m) return i;
        }
        return -1;
    }
};

作者:宫水三叶
来源:力扣(LeetCode)
这种算法当然是正确的,但有明显的重复比较。
举一个很典型的例子:
pattern: aaaaaaab
text:    aaaaaaaaaaaaaab
模式串前面连续出现大量的 a。
每一次在最后的 b 处失配以后,BF 都会把主串指针退回去,再重新比较那些已经比较过很多次的 a。
如果主串长度为
实际上,虽然某一次匹配失配了,但在这次的匹配过程中仍然获取了有用的信息。 BF 算法显然直接将这种信息浪费了。
KMP
前置知识:
前缀:对于字符串 abcxxxxefg,我们称 abc 属于 abcxxxxefg 的某个前缀。
后缀:对于字符串 abcxxxxefg,我们称 efg 属于 abcxxxxefg 的某个后缀。
不等于整个字符串本身的前缀(或后缀)是真前缀(或真后缀),就像真子集。
理解 KMP 的方式很直观:把模式串放在主串下面。当发生失配时,不回退主串,考虑继续把模式串向右移动。
例如已经匹配:
case1  S: · · · a b a b x · · ·
       P:       a b a b c
我们已经有信息:
此时 BF 算法会尝试把模式串向右移动一个位置,主串回退至
case2  S: · · · a b a b x · · ·
       P:         a b a b c
容易知道,如果在 case2 下继续向后匹配能成功,至少需要
的3位后缀等于 的3位前缀。本例中不能,"bab"!="aba".
然后
case3  S: · · · a b a b x · · ·
       P:           a b a b c
容易知道,如果在 case3 下继续向后匹配能成功,至少需要
的2位后缀等于 的2位前缀。本例中能,"ab"=="ab".
综上所述,可以发现 BF 算法似乎有可以化简的地方:
失配时,已匹配的字符串(如本例中的"abab")的前缀和后缀若有相等,那么我们移动到使得它们相配的情形(如 case3),接着匹配是有可能匹配成功的;反之,正如 case2 提到的,继续向后匹配不可能成功。
换句话说,我们可以略去 BF 算法中每次“把模式串向右移动一个位置”的步骤序列中的一些没有前景的步骤(如 case2),直接移动到下一个有可能匹配成功的位置(如 case3,这样的位置可以通过已匹配的字符串中相等的前后缀的长度算出),然后继续匹配。若匹配成功,结束;否则,继续移动到下一个有可能匹配成功的位置。
这要求我们掌握一个信息:已匹配的字符串的前缀和后缀是否有相等,而且我们只要相等的前后缀中最长的,这样模式串移动的距离最小,不会漏掉任何可能成功的匹配。
实际上,已匹配的字符串提供的信息完全包含在子串中,所以我们只需要用子串初始化算一遍,就能得到这些信息。
以下是具体的 KMP 算法讲解。
观察 case1 已经匹配上的部分
abab
可以发现,它的后缀 ab 同时也是它的前缀 ab。
因此可以直接这样:
S: · · · a b a b x · · ·
P:           a b a b c
前面这两个 ab 不需要再次比较。
更一般地,假设已经匹配成功
如果存在
也就是匹配成功的这一段主串
那么模式串
于是主串指针
接下来继续比较
我们当然希望找到最大的这样的
因此 KMP 需要预先知道当
这就是 next 数组。
next 数组
这里使用数据结构教材中常见的传统 next 数组:
对于 next[j] 记录
即
如果不存在非空的相等前后缀,则
例如
P = A B A B C A B
有
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | |
|---|---|---|---|---|---|---|---|
| A | B | A | B | C | A | B | |
| -1 | 0 | 0 | 1 | 2 | 0 | 1 |
重点看
因为
ABAB
它的最长相等真前缀与真后缀为
AB
长度是
因此当
失配时,不必令
而可以直接令
下面考虑 next 数组本身怎样计算。
设现在已经知道
按照定义,有
也就是:
P:  p0 p1 ... p[k-1] ··· p[j-k] ... p[j-1] p[j]
    |___________|          |_____________|
         相同                      相同
如果进一步有
那么两段相等字符串都可以再延长一个字符:
所以
代码中就是:
++j;
++k;
next[j] = k;
如果
则长度为
但仍然不能直接令
因为
本身也可能存在更短的相等前后缀,而这个位置已经由
记录下来。
因此令
再判断
如果仍然不同,就继续
直到找到能够继续延长的位置,或者退到
因此计算 next 的过程与 KMP 匹配本身几乎完全相同:
while (k != -1 && P[j] != P[k]) {
    k = next[k];
}
我们可以把模式串复制两份,让其中一份相对于另一份不断向右移动。换句话说,求 next 的过程就是模式串与自身进行匹配。
注:原论文采用的是从
开始的下标,并且论文中的 next还加入了失配字符本身的信息,是一个更进一步的版本。这里按照常见数据结构教材,只讨论传统的next[0]=-1,不使用nextval。
代码实现与总结
先构造 next 数组:
vector<int> getNext(const string& P) {
    int m = static_cast<int>(P.size());

    if (m == 0) {
        return {};
    }

    vector<int> next(m);

    int j = 0;
    int k = -1;

    next[0] = -1;

    while (j < m - 1) {
        if (k == -1 || P[j] == P[k]) {
            ++j;
            ++k;
            next[j] = k;
        } else {
            k = next[k];
        }
    }

    return next;
}
其中
k = next[k];
表示当前长度为
得到 next 数组以后,匹配过程为:
int KMP(const string& S, const string& P) {
    if (P.empty()) {
        return 0;
    }

    vector<int> next = getNext(P);

    int n = static_cast<int>(S.size());
    int m = static_cast<int>(P.size());

    int i = 0;
    int j = 0;

    while (i < n && j < m) {
        if (j == -1 || S[i] == P[j]) {
            ++i;
            ++j;
        } else {
            j = next[j];
        }
    }

    if (j == m) {
        return i - j;
    }

    return -1;
}
与 BF 对比会更加清楚。
BF 失配:
i = i - j + 1;
j = 0;
KMP 失配:
j = next[j];
也就是说,KMP 从始至终没有执行
--i;
或者其他形式的主串回退。
主串中的每个字符只向前扫描。
模式串虽然可能通过 next 多次向前跳转,但在整个匹配过程中,这些跳转的总次数仍然是线性的。
构造 next 数组需要
的时间,扫描长度为
的时间,因此总时间复杂度为
额外保存一个长度为 next 数组,所以空间复杂度为