这篇自用、AIGC 教程从第一行 Python 开始,最后完成一个小型分类实验。文章的基础知识选题参考了廖雪峰的 Python 教程 ,按深度学习中的使用顺序重新编排。语法和接口说明另附官方文档链接。正文与练习采用贯穿全文的小例子,便于前后对照。配套的 Jupyter Notebook 已按章节整理好代码与输出,也有可调节参数的小实验。想边读边运行,可以先下载;安装和使用方法见 9.8 节。
1. Python 初体验
1.1 Python、终端和编辑器各做什么
Python 程序通常保存在以 .py 结尾的文本文件里。编辑器负责修改文件,Python 解释器负责执行代码,终端用来输入启动程序、安装依赖等命令。
例如,在编辑器中新建 hello.py,写入:
print("你好,Python")
保存时确认文件名是 hello.py,没有被编辑器额外加上 .txt。在这个文件所在目录打开终端,运行:
python hello.py
终端会显示:
你好,Python
这里有两种语言:
print(...)是 Python 代码,python hello.py是终端命令。后者不应写进.py文件。 如果终端只有python3命令,可以先用python3 hello.py。Windows 上也可能使用py hello.py。下面会创建虚拟环境,激活后统一使用python。 输入python而不跟文件名,会进入交互式解释器,提示符通常是>>>。这时可以逐行输入 Python,输入exit()退出。某些教程的例子带有>>>,复制时应去掉提示符。本文的 Python 代码块都不带这个前缀。
1.2 给练习单独建一个环境
一个项目可能需要 PyTorch,另一个项目可能需要不同版本的包。虚拟环境让它们分别安装自己的依赖。可以把练习目录命名为 python-practice。在编辑器中打开这个目录,再打开内置终端;也可以在系统终端用 cd 切换到目录。例如目录位于桌面时,macOS 常用 cd ~/Desktop/python-practice。路径包含空格时需要用英文引号包围。确认进入练习目录后执行:
macOS / Linux:
python3 -m venv .venv
source .venv/bin/activate
Windows 的命令提示符(cmd):
py -m venv .venv
.venv\Scripts\activate.bat
.venv 是环境目录。激活环境只对当前终端会话生效,新开一个终端通常需要重新激活。-m venv 表示让指定的 Python 运行 venv 模块。
先确认正在使用的解释器:
python -c "import sys; print(sys.executable)"
输出路径应指向刚建立的 .venv。-c 后面的字符串是一小段要直接执行的 Python 代码。现在不必记住 import 的细节,第 7 章会讲。
前七章的基础练习只需要 Python 自带的功能。进入第 8 章时,再安装数值计算和绘图所需的包:
python -m pip install numpy matplotlib
PyTorch 的安装命令与系统、计算平台有关,请在官方安装页选择对应系统、Pip 和 Python;初学时选择 CPU 即可。将页面给出的 pip 或 pip3 换成当前环境的 python -m pip,保留后面的参数。这样安装位置与运行代码所用的解释器一致。安装页也会说明当前版本支持哪些 Python 版本。
安装完成后检查:
python -c "import torch; print(torch.__version__)"
如果出现 ModuleNotFoundError,先核对运行代码与安装包时是否用了同一个环境。反复安装到另一个解释器里,问题不会消失。
1.3 用脚本还是 Notebook
本文以 .py 文件为主。可以建一个 practice.py,每次替换其中的练习,保存后运行 python practice.py。
Jupyter Notebook 把代码分成若干单元格,可以分别执行,适合观察数组和图像。不过,它会保留之前执行过的变量。即使删掉定义变量的单元格,变量也可能仍在内存中;调整单元格顺序后,屏幕上的排列顺序也未必等于实际执行顺序。
如果使用 Notebook,学完一章后重启内核,再从上到下运行一次。这样更容易发现漏掉的定义。编辑器和 Notebook 的解释器选择也应指向前面创建的环境。
本章练习:把问候语换成自己的名字,再分别尝试在终端执行脚本和在交互式解释器里调用 print。能分清这两种执行方式,就可以往下读。
2. 变量与基本类型
上一章已经能运行一个文件。接下来,我们让程序保存一些数值,并根据这些数值计算结果。
2.1 赋值与计算
learning_rate = 0.01
epochs = 20
print(learning_rate)
print(epochs)
= 表示赋值:先计算右边,再让左边的名称指向这个结果。learning_rate 和 epochs 是变量名。变量不需要提前声明类型,这里的值分别是浮点数和整数。
学习率用于控制模型每次更新参数的幅度;epoch 表示完整遍历训练数据的一轮。暂时只需要把它们看作两个有具体用途的数值。
变量名区分大小写,epochs 与 Epochs 是两个名称。常用的小写加下划线写法,如 batch_size,能让多个单词更容易辨认。
step = 0
step = step + 1
print(step)  # 1
第二行先算出 0 + 1,再把 step 绑定到 1。它也可以写成 step += 1。程序按执行顺序读取变量,所以同一个名称在不同位置可能对应不同的值。数学等式不会这样使用等号,读程序时要留意这个差别。
# 后面是注释,解释器会忽略。注释适合说明用途、单位或容易误解的地方。
常见运算符如下:
| 写法 | 含义 | 结果 |
|---|---|---|
7 + 2 |
加法 | 9 |
7 - 2 |
减法 | 5 |
7 * 2 |
乘法 | 14 |
7 / 2 |
除法 | 3.5 |
7 // 2 |
向下取整的除法 | 3 |
7 % 2 |
取余数 | 1 |
2 ** 3 |
乘方 | 8 |
// 的结果向负无穷取整,所以 -7 // 2 是 -4。** 才是乘方;^ 在 Python 中是按位异或,不能拿来写平方。
2.2 数字、字符串、布尔值和 None
sample_count = 100          # int,整数
accuracy = 0.875            # float,浮点数
experiment = "first_run"   # str,字符串
shuffle = True             # bool,布尔值
checkpoint = None          # 暂时没有检查点路径

print(type(sample_count))
print(type(accuracy))
输出:
<class 'int'>
<class 'float'>
type(...) 可以查看一个值的类型。遇到不理解的运算结果时,先打印类型往往比猜测有效。
字符串用英文单引号或双引号包围,两者都可以。编辑器里输入代码时应使用英文标点,中文引号 “ ” 无法代替字符串的引号。
print("3" + "2")  # 32,拼接字符串
print(3 + 2)      # 5,数字相加
print(int("3") + 2)  # 5,把字符串转成整数
True 和 False 首字母大写。比较运算会得到布尔值:
print(3 == 3)   # True,判断相等
print(3 != 3)   # False,判断不等
print(0.8 >= 0.9)  # False
None 用来表示缺失或尚未提供的值。例如,没有指定模型文件时,可以把路径设为 None。检查它通常写 checkpoint is None。0、空字符串和 None 各有不同含义,是否视为缺失应由程序约定。
浮点数只能有限精度地表示数值:
print(0.1 + 0.2) # 0.30000000000000004
因此,计算结果是否接近某个小数,通常需要允许一个误差范围。后面比较张量时,会使用相应的近似比较方法。
2.3 输出可读的训练记录
epoch = 3
loss = 0.12678
accuracy = 0.875
print(f"第 {epoch} 轮,loss={loss:.3f},准确率={accuracy:.1%}")
输出:
第 3 轮,loss=0.127,准确率=87.5%
字符串前面的 f 允许在花括号中插入表达式。:.3f 保留三位小数,:.1% 按百分数显示并保留一位小数。它们只影响显示格式,变量里的值没有改变。
loss 称为损失,用一个数衡量预测与目标的偏差。如何计算它将在第 9 章介绍,目前只是练习输出一个小数。
2.4 缩进也是语法
accuracy = 0.875
if accuracy >= 0.8:
    print("达到本次练习的目标")
    print("可以保存结果")
print("程序结束")
if 后面是条件,冒号后面换行。缩进的两行属于条件成立时执行的代码块,最后一行回到最左边,无论条件是否成立都会执行。
本文统一用四个空格缩进。可以让编辑器把 Tab 自动转换为空格,避免混用。复杂代码可以先通过缩进找出它的层次,再读每一行的内容。
本章练习:共有 80 个样本,预测正确 62 个。用变量保存这两个数,计算准确率,并用 f-string 输出一位小数的百分比。答案应是 77.5%。注意参与计算的数值应为整数,别加上字符串引号。
3. 用容器组织数据
单个变量适合保存学习率。如果要保存一百条样本,总不能依次定义 sample1、sample2……接下来用容器把相关数据放在一起。
从这一章开始,我们用平面上的点作为样本。每个点有两个坐标,标签用 0 或 1 表示所属类别。到最后,模型将根据坐标预测类别。
3.1 列表与索引
point = [0.2, 0.7]
print(point[0])   # 0.2
print(point[1])   # 0.7
print(point[-1])  # 0.7
print(len(point)) # 2
[] 创建列表,列表中的位置从 0 开始编号。负数索引从末尾向前数,-1 是最后一个元素。len 返回元素数量。
长度为 2 的列表没有 point[2];访问它会出现 IndexError。这个错误通常说明索引超出了范围,应检查列表长度和索引的来源。
列表能嵌套:
points = [[0.2, 0.7], [-0.8, -0.3], [0.6, -0.1]]
labels = [1, 0, 1]
print(points[1])     # [-0.8, -0.3]
print(points[1][0])  # -0.8
points[1][0] 分两步读取:先取第二个点,再取该点的第一个坐标。这里约定 points[i] 与 labels[i] 对应同一个样本。后续调整顺序时,必须保持这种对应关系。
列表可以修改,也可以添加元素:
losses = [0.9, 0.6]
losses.append(0.4)
losses[0] = 1.0
print(losses)  # [1.0, 0.6, 0.4]
losses.append(...) 是调用列表的一个方法。点号把对象和它提供的属性或方法连起来;带括号表示调用。在这里,append 把值加到列表末尾。
append 修改原列表,返回值是 None。不要写 losses = losses.append(0.4),否则 losses 会被重新赋值为 None。
3.2 切片:一次取出一段
values = [10, 20, 30, 40, 50]
print(values[1:4])   # [20, 30, 40]
print(values[:3])    # [10, 20, 30]
print(values[3:])    # [40, 50]
print(values[::2])   # [10, 30, 50]
print(values[::-1])  # [50, 40, 30, 20, 10]
切片写作 起点:终点:步长,包含起点,不包含终点。省略起点或终点时,正向切片默认从开头开始或取到末尾。步长为负数时向前取,[::-1] 常用于倒序。
比如 points[:2] 取前两个点。这种写法之后会出现在训练集划分、批次抽取和张量索引中。
3.3 元组与解包
shape = (32, 2)
batch_size, feature_count = shape
print(batch_size)     # 32
print(feature_count)  # 2
元组通常用圆括号表示,创建后不能替换其中的元素,适合表达固定的一组值。这里的 shape 表示一批有 32 个样本,每个样本有两个特征,也就是两个坐标。
batch_size, feature_count = shape 叫解包:把右侧的两个元素依次赋给左侧的两个变量。普通解包时数量要一致。列表也支持同样的操作。
单元素元组要写成 (2,),逗号不能省略;(2) 只是加了括号的整数。
元组的不可变性指它所保存的各项引用不能被替换。如果其中有一个列表,列表自身仍可能被修改。因此,用元组包装数据并不等于把内部所有内容都冻结。
3.4 字典与集合
列表按位置取值,字典按键取值:
config = {
    "learning_rate": 0.01,
    "batch_size": 32,
    "epochs": 20,
}
print(config["batch_size"])       # 32
config["epochs"] = 30
print(config.get("device", "cpu"))  # cpu
print("epochs" in config)         # True
冒号左侧是键,右侧是值。配置项用字典保存,比记住某个数在列表的第几个位置更方便。config["device"] 在键不存在时会报 KeyError;get 可以指定默认值。
默认值适合可选配置。如果某项数据必须存在,直接索引能及时暴露缺失问题。什么都用默认值补上,可能让程序带着错误的配置继续运行。
集合可以去重,也适合检查成员是否存在:
labels = [1, 0, 1, 1, 0]
classes = set(labels)
print(len(classes))  # 2
print(1 in classes)  # True
集合不提供稳定的排列顺序。需要按编号显示类别时,可以用 sorted(classes) 得到排序后的列表。空集合用 set() 创建,{} 创建的是空字典。
3.5 赋值不会自动复制数据
这点值得单独运行一次:
a = [1, 2, 3]
b = a
b[0] = 99
print(a)  # [99, 2, 3]
a 和 b 指向同一个列表,所以通过 b 修改,也会在读取 a 时看到变化。如果需要一个独立的外层列表,可以这样写:
a = [1, 2, 3]
b = a.copy()
b[0] = 99
print(a)  # [1, 2, 3]
但 copy() 是浅复制。嵌套列表里的内层对象仍然共享:
a = [[1, 2], [3, 4]]
b = a.copy()
b[0][0] = 99
print(a)  # [[99, 2], [3, 4]]
需要递归复制这种嵌套结构时,可以使用标准库的 copy.deepcopy。到张量部分,还会遇到共享存储的问题;那时应区分赋值、切片、复制以及梯度关系,不能把列表的经验直接套到所有对象上。
本章练习:建立三个二维点和对应标签,取出第二个点,将两个坐标解包到 x1、x2,再取前两个点形成一个小批次。最后预测上面浅复制示例的输出,再运行检查。能解释为什么外层复制后内层仍会变化,比记住 copy 的名称更有用。
4. 遍历样本与控制执行顺序
现在样本已经保存在列表中。我们先不用神经网络,规定一个简单的分类规则:两个坐标之和大于 0 时,预测为类别 1,否则预测为类别 0。这个规则能让我们练习条件和循环;最后一章会让模型从数据中学习同样的分类任务。
4.1 条件判断
point = [0.2, 0.7]
score = point[0] + point[1]
if score > 0:
    prediction = 1
else:
    prediction = 0
print(prediction)  # 1
条件成立时执行 if 下的代码块,否则执行 else 下的代码块。需要依次检查多个条件时,可以加入 elif:
score = 0.03
if score > 0.1:
    print("明显位于正侧")
elif score < -0.1:
    print("明显位于负侧")
else:
    print("靠近分界线")
条件从上到下检查,执行第一个成立的分支后,就跳过其余分支。else 负责前面的条件都不成立时的情况。
多个条件可以用 and、or、not 组合,例如 score > 0 and score < 1,也可以写成 0 < score < 1。这几种写法适用于普通数值。以后对整批张量逐元素比较,要使用张量支持的逻辑运算,第 8 章会给出例子。
4.2 for 与 range
points = [[0.2, 0.7], [-0.8, -0.3], [0.6, -0.1]]
for point in points:
    score = point[0] + point[1]
    print(score > 0)
输出依次是 True、False、True。每轮循环,point 都绑定到列表中的下一个元素。循环体执行完后,才继续取下一个点。
只需要重复指定次数时,可以使用 range:
for epoch in range(3):
    print(f"开始第 {epoch + 1} 轮")
range(3) 依次提供 0、1、2,不包含 3。显示时加一,方便按日常习惯编号。range(1, 4) 则依次提供 1、2、3。
range 不会预先建立一个装满整数的列表。需要查看它的所有值时,可以写 list(range(3))。平时直接在循环中使用即可。
4.3 enumerate 与 zip
既要样本,又要编号,可以用 enumerate:
points = [[0.2, 0.7], [-0.8, -0.3], [0.6, -0.1]]
for index, point in enumerate(points):
    print(index, point)
enumerate 每次提供一对值:编号和当前元素。index, point 把这对值解包到两个变量。它默认从 0 编号,也可以用 enumerate(points, start=1)。
如果要同时读取样本和标签:
points = [[0.2, 0.7], [-0.8, -0.3], [0.6, -0.1]]
labels = [1, 0, 1]
correct = 0
for point, target in zip(points, labels):
    prediction = int(point[0] + point[1] > 0)
    if prediction == target:
        correct += 1
print(correct / len(labels))  # 1.0
zip 从两个容器中各取一个元素,组成一对。int(True) 得到 1,int(False) 得到 0,因此这里把条件判断的结果转成了类别编号。
zip 默认在最短的输入耗尽时结束。样本和标签数量不一致时,它可能悄悄少处理一些数据。Python 3.10 及以上可以写 zip(points, labels, strict=True),让长度不一致直接报错。
现在试着拆开这一行:
for index, (point, target) in enumerate(zip(points, labels)):
    print(index, point, target)
它接续上一个例子的变量。先由 zip 产生 (point, target),再由 enumerate 加上编号,形成 (index, (point, target))。左侧按同样的结构解包。后面看到 for batch_idx, (inputs, targets) in enumerate(loader) 时,语法结构完全相同。
4.4 推导式、break 与 continue
如果循环只是逐项计算结果并存入一个新列表,可以写成列表推导式:
values = [1, 2, 3, 4]
squares = [value ** 2 for value in values]
positive = [value for value in [-2, 0, 3, 5] if value > 0]
print(squares)   # [1, 4, 9, 16]
print(positive)  # [3, 5]
阅读顺序可以先看 for,确定数据来自哪里,再看前面的表达式,确定每项算什么。带有 if 时,先筛选,再计算。表达式太长或包含多层判断时,展开为普通循环会更容易维护。
continue 跳过本轮剩余代码,break 结束最近的一层循环:
values = [-1, 2, 4, 8]
for value in values:
    if value < 0:
        continue
    if value > 5:
        break
    print(value)
这里只输出 2 和 4。while 则在条件成立期间反复执行,例如 while step < 10:。使用它时要确保循环体有机会改变条件,否则可能一直运行。遍历现成数据或固定轮数时,for 通常更直接。
本章练习:把第三个标签故意改成 0,重新计算准确率。应得到约 0.667。再用 enumerate 输出预测错误的样本编号。参考思路是在判断 prediction != target 时打印编号,别在循环结束之后才检查最后一个样本。
5. 把重复步骤写成函数
上一章计算类别的表达式已经出现了几次。如果每个地方都重新写一遍,修改规则时就容易漏改。函数可以给这段计算起一个名字,把输入与结果之间的关系单独表达出来。
5.1 定义、调用与返回值
def predict_point(point):
    score = point[0] + point[1]
    return int(score > 0)

prediction = predict_point([0.2, 0.7])
print(prediction)  # 1
def 开始定义函数,point 是参数。定义时,函数体尚未运行;执行 predict_point(...) 才会把传入的列表交给它,并执行缩进部分。return 把结果交回调用处,同时结束本次调用。
函数体的第一行也可以放一个三引号字符串,说明参数和返回值,这叫文档字符串。三引号允许字符串跨行;最后的训练脚本开头也用它说明文件用途。
print 只负责显示内容。如果把函数里的 return 换成 print,调用时虽然能看到类别,但 prediction 会得到 None。函数没有执行带值的 return 时,默认返回 None。
一个函数可以返回多个相关结果:
def describe(values):
    return min(values), max(values)

low, high = describe([0.2, 0.7, -0.3])
print(low, high)  # -0.3 0.7
这里返回的是一个元组,调用处用解包接收。min 与 max 是 Python 自带的函数,分别求最小值和最大值。
5.2 位置参数、关键字参数和默认值
def predict_point(point, threshold=0.0):
    return int(point[0] + point[1] > threshold)

print(predict_point([0.2, 0.7]))                 # 1
print(predict_point([0.2, 0.7], 1.0))            # 0
print(predict_point([0.2, 0.7], threshold=1.0))  # 0
第一种调用采用默认阈值,第二种按位置传参,第三种按参数名传参。参数较多时,写出名称能减少顺序混淆。以后见到 nn.Linear(in_features=2, out_features=16),可以按这个方式阅读。
默认参数有一个常见陷阱:列表、字典等可变对象作为默认值时,会在多次调用间共享。不要用 def record(value, history=[]): 来表示每次都新建一个列表。可以写成:
def record(value, history=None):
    if history is None:
        history = []
    history.append(value)
    return history

print(record(0.8))  # [0.8]
print(record(0.6))  # [0.6]
传入已有列表时,函数会修改那个列表。这与第 3 章的引用关系一致:把对象传给函数,不会自动复制它。
5.3 看懂 *args 和 **kwargs
星号在函数定义和函数调用中有两种相关的用途:收集与展开。
定义时,*args 收集额外的位置参数,形成元组:
def total(*args):
    return sum(args)

print(total(1, 2, 3))  # 6
**kwargs 收集额外的关键字参数,形成字典:
def show_options(**kwargs):
    print(kwargs)

show_options(batch_size=32, shuffle=True)
输出:
{'batch_size': 32, 'shuffle': True}
args 和 kwargs 是约定俗成的名称,语法作用来自星号。多数日常函数写清楚具体参数就足够了;这里主要是为阅读框架代码做准备。
调用时,星号把已有容器展开为参数:
def add(a, b):
    return a + b

values = [2, 3]
options = {"a": 2, "b": 3}
print(add(*values))     # 等价于 add(2, 3)
print(add(**options))   # 等价于 add(a=2, b=3)
展开字典时,键必须符合函数可接收的参数名;同一个参数也不能既按位置传入,又通过字典重复传入。
5.4 作用域与类型提示
函数内部创建的变量通常只在该次调用内部使用:
def scale(value, factor):
    result = value * factor
    return result

answer = scale(3, 2)
print(answer)  # 6
外部可以读取 answer,却不能直接读取函数里的局部变量 result。需要输出什么,就通过 return 返回;需要输入什么,尽量通过参数传入。这样单独阅读函数时,比较容易看清依赖。
你还可能遇到:
def scale(value: float, factor: float = 2.0) -> float:
    return value * factor
参数后的 : float 和箭头后的 float 是类型提示。它们帮助读者、编辑器和检查工具理解预期类型,Python 默认不会据此自动转换数值或强制拒绝其他类型。scale("a", 2) 仍会得到字符串 "aa"。
lambda x: x * 2 是一种简短的匿名函数写法,适合很短的表达式。需要多行步骤、注释或重复使用时,用 def 会更清楚。有关参数的完整规则,可以按需查阅 Python 函数定义文档。
本章练习:定义 accuracy(predictions, targets),返回两个类别列表的匹配比例。先检查长度是否相等,并规定空列表怎样处理。可以暂时为无效输入返回 None;第 7 章学会异常后,再改为明确报错。用 [1, 0, 1] 和 [1, 0, 0] 检查,结果应约为 0.667。
6. 类与对象:为 Dataset 和模型做准备
函数把一段操作集中起来。随着程序变大,还会有一组长期使用的数据,以及围绕这些数据的操作。例如,一个数据集既保存样本,也需要回答有多少条样本、如何读取第几条。类适合表达这样的对象。
6.1 从一个保存样本的类开始
class PointDataset:
    def __init__(self, points, labels):
        self.points = points
        self.labels = labels

    def __len__(self):
        return len(self.points)

    def __getitem__(self, index):
        return self.points[index], self.labels[index]

samples = PointDataset([[0.2, 0.7], [-0.8, -0.3]], [1, 0])
print(len(samples))  # 2
print(samples[0])    # ([0.2, 0.7], 1)
class PointDataset: 定义一种对象。PointDataset(...) 创建一个实例;初始化过程中,__init__ 接收传入的数据,把它们保存到实例属性上。
self 表示当前实例。self.points = points 左边是保存到实例上的属性,右边是本次调用传入的参数。构造函数返回后,局部参数的名称结束使用,但通过 samples.points 仍能读取保存的样本。
方法是定义在类中的函数。调用实例方法时,Python 会自动把实例传给第一个参数,所以创建对象或调用普通实例方法时,一般不手动填写 self。这个名字本身是惯例,保持惯例最容易让别人读懂。
__len__ 和 __getitem__ 是特殊方法,分别让对象支持 len(samples) 与 samples[index]。双下划线也是方法名的一部分,需要准确拼写。仅有这个例子还不能处理任意输入,比如样本与标签长度不一致时会出问题;正式实现中应验证这类约束。
6.2 实例属性与类属性
每个实例需要独立保存的数据,通常在 __init__ 中写到 self 上。例如训练历史可以用 self.history = [] 初始化。
如果在类的最外层写 history = [],它会成为类属性,由实例共同访问。一个实例修改这个列表,其他实例也可能看到变化。初学时把每个对象自己的可变状态放到实例属性上,可以避开这类共享问题。
类也可以保存参数并提供计算方法:
class LinearRule:
    def __init__(self, weight, bias=0.0):
        self.weight = weight
        self.bias = bias

    def score(self, value):
        return self.weight * value + self.bias

rule = LinearRule(weight=2.0, bias=1.0)
print(rule.score(3.0))  # 7.0
这个对象保存了 weight 与 bias,每次计算时复用它们。神经网络也会保存参数,只是参数通常是张量,计算结构也更复杂。
6.3 继承与 super
继承允许一个类沿用另一个类的行为,再添加或修改部分方法:
class BaseExperiment:
    def __init__(self, name):
        self.name = name

    def describe(self):
        return f"实验:{self.name}"

class ClassificationExperiment(BaseExperiment):
    def __init__(self, name, class_count):
        super().__init__(name)
        self.class_count = class_count

experiment = ClassificationExperiment("二维点分类", 2)
print(experiment.describe())  # 实验:二维点分类
括号里的 BaseExperiment 是父类。super().__init__(name) 在这里调用父类的初始化方法,建立 name 属性,随后子类增加自己的 class_count。
阅读 class Classifier(nn.Module) 时,可以沿用这个思路:Classifier 继承 PyTorch 的 nn.Module,后者提供参数管理、设备迁移等功能;我们负责定义网络层和前向计算。第 9 章会给出完整实现。现在先认识结构,不必提前记住网络接口。
super() 在复杂的多重继承中遵循方法解析顺序,不能一概理解成固定指向某个父类。本教程只使用上面这样的单继承。
6.4 可迭代对象、迭代器与生成器
列表能够出现在 for 后面,因为它支持迭代。可以显式取得一个迭代器,再逐次取值:
values = [10, 20]
iterator = iter(values)
print(next(iterator))  # 10
print(next(iterator))  # 20
再调用一次 next 会产生 StopIteration,表示没有更多元素。for 会处理正常的迭代结束,因此不需要在循环里手动捕获它。迭代器被取完后,通常需要从原来的可迭代对象重新创建一个。
生成器是一种方便编写迭代器的方式:
def batches(values, batch_size):
    for start in range(0, len(values), batch_size):
        yield values[start:start + batch_size]

for batch in batches([10, 20, 30, 40, 50], 2):
    print(batch)
输出:
[10, 20]
[30, 40]
[50]
yield 交出当前批次,并暂停函数;下次请求元素时从暂停处继续。调用含有 yield 的函数会创建生成器,实际取值时才执行函数体。例子约定 batch_size 是正整数。
一个 batch 就是一起处理的一小批样本。这里最后一批只有一个元素,可见批次大小不一定整齐。后面计算整轮平均损失时,需要按实际样本数加权。
生成器按需生成批次,但这个例子的 values 已经完整保存在内存中,不能因此认为原始数据也没有占用内存。PyTorch 的 DataLoader 会提供更完整的分批与加载功能。
本章练习:给 PointDataset 增加第三条数据,检查 len(samples) 与 samples[2] 的结果。再把生成器的批次大小改为 3,预测输出。有关对象和继承的更多规则,见 Python 类与迭代器文档。
7. 文件、模块与报错
前面已经能用函数和类组织代码。接下来把它们放入文件,保存实验配置,并学习怎样定位运行错误。这些步骤会直接用于最后的训练脚本。
7.1 import 与程序入口
把第五章的预测函数放进 helpers.py:
def predict_point(point, threshold=0.0):
    return int(point[0] + point[1] > threshold)
在同一个目录新建 main.py:
from helpers import predict_point


def main():
    prediction = predict_point([0.2, 0.7])
    print(prediction)


if __name__ == "__main__":
    main()
在这个目录运行 python main.py,应输出 1。
一个 .py 文件可以作为模块被导入。from helpers import predict_point 从该模块中取得指定名称;也可以写 import helpers,然后用 helpers.predict_point(...) 调用。
文件被直接运行时,__name__ 的值是 "__main__";被普通导入时,它通常是模块名。入口判断让 main() 只在直接运行文件时执行。否则,别人只是导入你的模型定义,也可能意外开始训练。
导入模块仍会执行模块顶层代码,因此把耗时工作放进函数并由入口调用很有必要。import numpy as np 中的 as 给模块起别名,后面用 np 访问它。
不要把自己的脚本命名为 torch.py、numpy.py 或 json.py,这些名称可能遮住要导入的包,导致令人困惑的导入错误。
7.2 路径与 JSON 配置
from pathlib import Path
import json

output_dir = Path("outputs")
output_dir.mkdir(parents=True, exist_ok=True)
config = {"learning_rate": 0.01, "batch_size": 32}

with (output_dir / "config.json").open("w", encoding="utf-8") as file:
    json.dump(config, file, ensure_ascii=False, indent=2)

with (output_dir / "config.json").open("r", encoding="utf-8") as file:
    loaded_config = json.load(file)

print(loaded_config["batch_size"])  # 32
Path 表示路径,/ 在这里用于拼接目录和文件名。mkdir 创建目录;parents=True 允许同时创建缺少的父目录,exist_ok=True 允许目录已经存在。
"w" 是写入模式,会覆盖同名文件原有内容;"r" 是读取模式。with 负责在代码块结束时关闭文件,即使中途出现异常,也会执行相应的清理操作。后面会见到 with torch.no_grad():,形式相似,但它管理的是梯度记录状态。
JSON 适合保存数字、字符串、列表、字典等基础配置。dump 写入文件,load 从文件读取。张量无法直接交给普通 json.dump 保存,模型参数会使用 PyTorch 的保存接口。
相对路径从当前工作目录解析,不一定从脚本所在目录解析。遇到找不到文件时,先打印 Path.cwd()。需要相对于脚本定位文件时,可以在 .py 文件中使用 Path(__file__).resolve().parent;Notebook 通常没有 __file__。
7.3 读懂 traceback
假设代码写成:
values = [10, 20]
# print(values[2])  # 去掉注释会触发 IndexError
报错会包含文件名、行号和调用过程,最后一行给出异常类型与简要原因。先看最后一行,再回到属于自己代码的出错位置,检查参与运算的值。
| 异常 | 常见检查方向 |
|---|---|
NameError |
名称是否拼错,定义是否已经执行 |
TypeError |
对象类型、参数数量、是否误把属性当函数调用 |
IndexError |
索引是否越界 |
KeyError |
字典是否包含这个键 |
ModuleNotFoundError |
包是否装在当前解释器环境中 |
RuntimeError |
阅读具体信息;张量形状或设备不匹配常由它报告 |
调试时先缩小范围。例如在报错前打印 type(value) 和 value;到了张量部分,再打印 shape、dtype 和 device。观察到的实际值,比变量名称更可靠。
7.4 主动拒绝无效输入
第五章的准确率函数可以完善为:
def accuracy(predictions, targets):
    if len(predictions) != len(targets):
        raise ValueError("预测数量与标签数量不一致")
    if len(targets) == 0:
        raise ValueError("无法计算空数据集的准确率")
    correct = sum(p == t for p, t in zip(predictions, targets))
    return correct / len(targets)

print(accuracy([1, 0, 1], [1, 0, 0]))  # 0.6666666666666666
raise 主动抛出异常。这里传给 sum 的是生成器表达式:逐对比较,True 在求和时贡献 1,False 贡献 0。
如果调用处有明确的处理方式,可以捕获预期异常:
try:
    value = int("not-a-number")
except ValueError:
    print("输入无法转换为整数")
不要把整段训练包进一个宽泛的 try,然后用 except: pass 忽略所有错误。程序继续运行,却没有完成原本的工作,会使问题更难追踪。
本章练习:把准确率函数放进 helpers.py,从 main.py 导入,并分别测试正常输入、长度不同和空列表。确认后两种情况能指出具体问题,再继续学习张量。
8. 从列表到张量
Python 列表能保存样本,但它的运算方式不适合直接做批量数值计算。例如 [1, 2] * 2 得到 [1, 2, 1, 2],而两个列表相加会拼接它们。训练模型时,我们更常需要每项乘二、对每列求平均,或一次计算一批样本。
8.1 先认识 NumPy 数组
import numpy as np

array = np.array([[1, 2], [3, 4]], dtype=np.float32)
print(array * 2)
print(array.shape)
print(array.mean(axis=0))
输出:
[[2. 4.]
 [6. 8.]]
(2, 2)
[2. 3.]
NumPy 数组的 * 2 对每个元素相乘。shape 表示每个维度的长度,这里有两行、两列。dtype 指定元素类型,float32 是 32 位浮点数。
mean(axis=0) 沿第 0 个轴求平均,把行这一维归约掉,留下每列的平均值。因此结果是 [(1+3)/2, (2+4)/2]。mean(axis=1) 则得到每一行的平均值 [1.5, 3.5]。
NumPy 常用于数据处理。PyTorch 的张量提供类似的数值操作,并支持自动求导以及在适当硬件上进行加速运算。下面直接转入张量,NumPy 的更多接口可以以后按需补充。
8.2 shape、dtype、device
import torch

x = torch.tensor([[1, 2], [3, 4], [5, 6]], dtype=torch.float32)
print(x.shape)   # torch.Size([3, 2])
print(x.dtype)   # torch.float32
print(x.device)  # cpu
print(x.ndim)    # 2
这个张量表示三个样本,每个样本有两个特征。shape 回答数据怎样排列,dtype 回答元素用什么类型保存,device 回答数据放在哪里。多数入门张量错误都可以先从这三项排查。
维度编号从 0 开始。这里 x.shape[0] 是样本数,x.shape[1] 是特征数。ndim 是轴的数量,不等于样本数,也不等于元素总数。
| 形状 | 本文约定的含义 |
|---|---|
[] |
标量,例如一个平均损失 |
[2] |
一个点的两个坐标 |
[32, 2] |
一批 32 个点 |
[32] |
这批点对应的 32 个类别编号 |
[32, 2] |
也可能是每个点对两个类别的预测分数 |
最后两种二维数据可以有相同形状,却有不同含义。形状只能说明尺寸,具体语义要结合变量用途判断。
浮点输入与整数标签常这样创建:
features = torch.tensor([[0.2, 0.7], [-0.8, -0.3]], dtype=torch.float32)
labels = torch.tensor([1, 0], dtype=torch.long)
本教程使用类别编号形式的交叉熵损失,所以标签采用 torch.long。其他任务可能需要浮点目标,不能把所有标签都机械地转成整数。
8.3 按行、按列取值
import torch

x = torch.tensor([[1., 2.], [3., 4.], [5., 6.]])
print(x[0])       # tensor([1., 2.])
print(x[:, 0])    # tensor([1., 3., 5.])
print(x[:2])      # 前两个样本,形状 [2, 2]
print(x[:, 0:1])  # 第一列,保留形状 [3, 1]
多维索引用逗号分隔每个维度。x[:, 0] 中,冒号取所有行,0 取第一列。整数索引会移除被选中的那一维;切片 0:1 会保留它,所以 [3] 与 [3, 1] 有区别。
布尔张量也能筛选:
mask = x[:, 0] > 2
print(mask)     # tensor([False, True, True])
print(x[mask])  # 取出后两行
这里接续上面的 x。如果要组合逐元素条件,可写 (x[:, 0] > 2) & (x[:, 1] < 6),各条件用括号包好。对包含多个元素的张量直接写 if x > 0:,程序无法知道你要求所有元素成立还是任意一个成立。需要明确写出 (x > 0).all() 或 (x > 0).any(),或用掩码逐项处理。
8.4 逐元素运算、矩阵乘法与广播
import torch

x = torch.tensor([[1., 2.], [3., 4.]])
print(x * x)
print(x @ x)
输出:
tensor([[ 1.,  4.],
        [ 9., 16.]])
tensor([[ 7., 10.],
        [15., 22.]])
* 对对应位置相乘,@ 做矩阵乘法。矩阵乘法把左侧的一行与右侧的一列对应相乘再求和,例如结果左上角是 1*1 + 2*3 = 7。
对于二维矩阵,[B, D] @ [D, H] 的结果是 [B, H]。中间的 D 必须一致。可以把它理解为一批 B 个样本,每个有 D 个特征,经过权重矩阵后变成 H 个数。
广播允许一些形状不同的张量做逐元素运算:
import torch

x = torch.tensor([[1., 2.], [3., 4.], [5., 6.]])
bias = torch.tensor([10., 20.])
print(x + bias)
结果是 [[11, 22], [13, 24], [15, 26]] 对应的浮点张量。长度为 2 的 bias 被用于每一行。
判断能否广播时,从最右边的维度向左比较:长度相等,或者其中一个为 1,即可兼容;缺少的前置维度按 1 处理。例如 [3, 2] 与 [2] 能得到 [3, 2],但 [3, 2] 与 [3] 不能直接相加。这个规则与 NumPy 广播规则一致。
尤其要留意 [B, 1] 与 [B]。二者相减可能得到 [B, B],这时每个值都与另一组的所有值进行了比较。如果你原本只想逐样本相减,程序虽然能运行,计算含义却变了。排查损失异常时,应同时核对结果形状。
8.5 改变形状与求平均
import torch

x = torch.arange(6, dtype=torch.float32).reshape(3, 2)
print(x)
print(x.mean(dim=0))               # tensor([2., 3.])
print(x.mean(dim=1))               # tensor([0.5000, 2.5000, 4.5000])
print(x.mean(dim=1, keepdim=True).shape)  # torch.Size([3, 1])
print(x.reshape(-1).shape)         # torch.Size([6])
arange(6) 生成从 0 到 5 的数,reshape(3, 2) 把六个元素排成三行两列。改变形状前后,元素总数必须一致;-1 让程序推算这一维的长度,一次最多使用一个。
PyTorch 通常用 dim 指定归约的轴,NumPy 的类似参数叫 axis。keepdim=True 保留被归约的维度,长度变为 1。例如每行减去自己的均值时,可以写 x - x.mean(dim=1, keepdim=True),这样 [3, 1] 会沿列广播。
unsqueeze 增加一个长度为 1 的维度:一个形状为 [2] 的点,经 point.unsqueeze(0) 后变成 [1, 2],就可以作为只有一条样本的批次输入模型。squeeze(dim=1) 则移除指定的长度为 1 的维度。直接调用不带维度的 squeeze() 会移除所有长度为 1 的维度,批次恰好只有一个样本时容易误删批次维。
reshape 按元素顺序重新安排形状,转置则交换轴。对于上面的 x,x.reshape(2, 3) 与 x.transpose(0, 1) 虽然形状相同,元素排列却不同。交换图像的通道轴时,应该学习 permute 或 transpose,不要仅靠 reshape 凑尺寸。
8.6 张量也可能共享数据
import torch

x = torch.tensor([1., 2., 3.])
y = x[:2]
y[0] = 9
print(x)  # tensor([9., 2., 3.])
张量的基本切片通常产生视图,和原张量共享底层存储。需要独立副本时用 clone()。reshape 可能返回视图,也可能复制,取决于布局,因此不要依靠它来保证数据独立。
从 NumPy 转换时也要留意:torch.from_numpy(array) 通常共享数组存储;修改一方可能影响另一方。torch.tensor(array) 则会复制数据。更多示例见 PyTorch 张量教程。
后面自动求导会用到 detach():它得到一个脱离当前求导关系的张量,但仍共享存储。如果既要脱离求导关系,又要独立数据,应使用 detach().clone()。
8.7 自动求导先看一个数
import torch

w = torch.tensor(2.0, requires_grad=True)
loss = (w - 5) ** 2
loss.backward()
print(loss.item())  # 9.0
print(w.grad)      # tensor(-6.)
requires_grad=True 表示要跟踪涉及 w 的计算,用于之后求导。backward() 根据已经发生的计算求出梯度,保存到 w.grad。
这里的函数是 (w-5)²,导数为 2(w-5),在 w=2 时等于 -6。如果沿梯度的反方向小幅移动:w ← w - 0.1 × (-6),新的 w 是 2.6,更接近使损失最小的 5。神经网络训练中,参数很多,优化器会替我们执行相应更新。
backward() 只计算梯度,不会自行更新 w。梯度默认会累积,多次训练时需要适时清除;第 9 章的 optimizer.zero_grad() 就负责这件事。
.item() 把单元素张量转为 Python 数值,适合打印和记录。要参与求导的损失应保留张量形式;先转成普通数字,就不能再对这个数字调用 backward()。
记录 loss 时可以保存 loss.item(),避免把带有求导关系的张量长期装进历史列表。求导流程详见 PyTorch 自动求导教程。
8.8 设备迁移
本文的示例使用 CPU。以后需要加速时,可以在设备可用的前提下选择 CUDA 或 macOS 的 MPS。迁移张量通常写 x = x.to(device),模型也需要迁移;参与同一次运算的数据和参数应放在兼容的设备上。
.to(...) 可能返回新张量,因此不要调用后就丢弃返回值。要把用于求导或位于加速设备上的张量交给常见的 NumPy 绘图流程,可以使用 tensor.detach().cpu().numpy()。先脱离求导关系,再移到 CPU,最后转换为数组。
本章练习:创建形状为 [4, 2] 的浮点张量,完成四件事:取第一列、计算每行均值、保留维度后进行逐行去均值、给一个点增加批次维。每一步先写下预计形状,再打印核对。最后解释为什么 [4, 1] - [4] 会得到 [4, 4]。
9. 完成一个小型分类实验
前面用过的二维点、标签、循环、函数、类,现在可以放到同一份训练程序里了。本章会先解释几个新增接口,再给出完整代码。读到长代码时,可以沿着入口函数向下追踪调用,不需要一次把所有细节记住。
9.1 数据与任务
我们生成 600 个二维点,仍按 x1 + x2 > 0 标注为类别 1,其余标注为类别 0。随机打乱后,480 个用于训练,120 个留到训练结束后评估。标签由已知规则生成,目的是观察训练流程是否按预期工作。
训练时把坐标输入模型,用预测分数与标签计算损失,再依据梯度调整参数。留出的测试集不参与参数更新。
这个任务用线性分类器就能解决。下面加一个小型隐藏层,是为了练习多层网络的写法。它的表现不能代表真实图像或文本任务中的效果;合成数据没有那些任务的复杂性。
9.2 Dataset 与 DataLoader
第 6 章的 PointDataset 只需继承 torch.utils.data.Dataset,并继续实现 __len__、__getitem__,就能交给 DataLoader 使用。
Dataset 负责按编号提供单条样本,DataLoader 负责抽取、分批并组织成适合训练的形式。我们设置 batch_size=32,每次提供 32 个点;shuffle=True 让每轮训练采用打乱后的顺序;num_workers=0 在当前进程加载,便于先排查代码问题。
对于本例,一次循环取到的 inputs 形状是 [32, 2],targets 是 [32]。两者通过 for inputs, targets in loader 解包。这些尺寸由数据集的单条返回值和批次大小共同决定。更多数据加载例子见 Datasets & DataLoaders。
9.3 模型怎样把坐标变成分数
我们的模型依次执行三个步骤:
| 步骤 | 输入形状 | 输出形状 | 作用 |
|---|---|---|---|
nn.Linear(2, 16) |
[B, 2] |
[B, 16] |
对每个点的两个坐标做可学习的线性变换,并加上偏置 |
nn.ReLU() |
[B, 16] |
[B, 16] |
把负值变为 0,非负值保留 |
nn.Linear(16, 2) |
[B, 16] |
[B, 2] |
产生两个类别的分数 |
B 代表当前批次的样本数。隐藏层的 16 是这次实验选择的宽度,与类别数无关。输出的 2 则对应类别 0 和类别 1。
nn.Sequential 按顺序调用其中各层。forward 定义前向计算,也就是输入怎样一步步得到输出。调用时写 model(inputs),PyTorch 的模块调用机制会执行 forward,同时处理注册的钩子等工作,通常不直接写 model.forward(inputs)。模块行为可查阅 nn.Module 文档。
输出分数通常叫 logits,可以为负,也不要求和为 1。argmax(dim=1) 在每行选择分数最大的类别编号。例如 [0.4, 1.2] 对应预测类别 1。
9.4 损失、梯度与更新
本例使用 nn.CrossEntropyLoss()。输入 logits 的形状为 [B, 2],标签是形状 [B] 的 long 张量,元素为 0 或 1。这种用法直接接收原始分数,不需要先调用 softmax。CrossEntropyLoss 文档
训练一个批次的步骤如下:
清除旧梯度 → 前向计算 → 计算损失 → 反向求导 → 更新参数
optimizer.zero_grad() 清除之前累积的梯度,loss.backward() 计算当前梯度,optimizer.step() 更新模型参数。漏掉 step(),参数不会按梯度更新;无意中漏掉清梯度,后续梯度会与之前的梯度累积。
SGD 是一种优化方法。创建优化器时传入 model.parameters(),说明要更新哪些参数;lr 就是第 2 章开始使用的学习率。第 8 章手算的梯度下降更新,是理解这里行为的起点。
评估时同时使用 model.eval() 和 torch.no_grad()。eval() 切换会区分训练与评估行为的层,例如 Dropout 和 BatchNorm;no_grad() 关闭代码块中的梯度记录。本例只有 Linear 和 ReLU,两种模型模式下的层行为相同,但先建立完整的评估写法,之后增加其他层时会少出错。
9.5 完整脚本
将下面代码保存为 train.py,在已安装 PyTorch 的环境中运行 python train.py。也可以直接下载训练脚本。生成的数据只用于本次学习,不需要联网下载数据集。
"""二维点分类。运行:python train.py。仅使用 CPU,不下载数据。"""
from pathlib import Path
import json

import torch
from torch import nn
from torch.utils.data import Dataset, DataLoader


class PointDataset(Dataset):
    def __init__(self, points, labels):
        if len(points) != len(labels):
            raise ValueError("样本数量与标签数量不一致")
        self.points = points
        self.labels = labels

    def __len__(self):
        return len(self.points)

    def __getitem__(self, index):
        return self.points[index], self.labels[index]


class Classifier(nn.Module):
    def __init__(self):
        super().__init__()
        self.layers = nn.Sequential(
            nn.Linear(2, 16),
            nn.ReLU(),
            nn.Linear(16, 2),
        )

    def forward(self, x):
        return self.layers(x)


def make_data(seed=42):
    generator = torch.Generator().manual_seed(seed)
    points = torch.randn(600, 2, generator=generator)
    labels = (points[:, 0] + points[:, 1] > 0).long()
    order = torch.randperm(len(points), generator=generator)
    train_ids, test_ids = order[:480], order[480:]
    return points[train_ids], labels[train_ids], points[test_ids], labels[test_ids]


def train_epoch(model, loader, loss_fn, optimizer):
    model.train()
    loss_sum = 0.0
    sample_count = 0
    for inputs, targets in loader:
        optimizer.zero_grad()
        logits = model(inputs)
        loss = loss_fn(logits, targets)
        loss.backward()
        optimizer.step()
        loss_sum += loss.item() * len(inputs)
        sample_count += len(inputs)
    return loss_sum / sample_count


def evaluate(model, points, labels, loss_fn):
    model.eval()
    with torch.no_grad():
        logits = model(points)
        loss = loss_fn(logits, labels).item()
        predictions = logits.argmax(dim=1)
        accuracy = (predictions == labels).float().mean().item()
    return loss, accuracy


def run_experiment(learning_rate=0.03, epochs=40, seed=42, verbose=True):
    torch.manual_seed(seed)
    train_x, train_y, test_x, test_y = make_data(seed)
    dataset = PointDataset(train_x, train_y)
    generator = torch.Generator().manual_seed(seed + 1)
    loader = DataLoader(dataset, batch_size=32, shuffle=True,
                        num_workers=0, generator=generator)
    model = Classifier()
    loss_fn = nn.CrossEntropyLoss()
    optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)
    history = []
    for epoch in range(epochs):
        loss = train_epoch(model, loader, loss_fn, optimizer)
        history.append(loss)
        if verbose and (epoch == 0 or (epoch + 1) % 10 == 0):
            print(f"epoch={epoch + 1:02d}, train_loss={loss:.4f}")
    test_loss, test_accuracy = evaluate(model, test_x, test_y, loss_fn)
    if verbose:
        print(f"test_loss={test_loss:.4f}, test_accuracy={test_accuracy:.1%}")
    return model, history, test_x, test_y, test_accuracy


def main():
    # 小数据使用一个 CPU 线程,减少线程调度开销。
    torch.set_num_threads(1)
    model, history, test_x, test_y, test_accuracy = run_experiment()
    output_dir = Path("outputs")
    output_dir.mkdir(parents=True, exist_ok=True)
    torch.save(model.state_dict(), output_dir / "point-model.pt")
    with (output_dir / "history.json").open("w", encoding="utf-8") as file:
        json.dump({"train_loss": history, "test_accuracy": test_accuracy}, file, indent=2)

    restored = Classifier()
    state = torch.load(output_dir / "point-model.pt", map_location="cpu", weights_only=True)
    restored.load_state_dict(state)
    restored.eval()
    model.eval()
    with torch.no_grad():
        before = model(test_x)
        after = restored(test_x)
        print("保存前后预测一致:", torch.allclose(before, after))
        new_points = torch.tensor([[0.2, 0.7], [-0.8, -0.3]], dtype=torch.float32)
        print("新样本预测:", restored(new_points).argmax(dim=1).tolist())


if __name__ == "__main__":
    main()
9.6 沿着入口读一遍
执行文件后,末尾的入口判断调用 main()。它先调用 run_experiment() 完成训练,再保存模型、重新载入并预测两个新点。
make_data() 使用固定随机种子生成数据。randn(600, 2) 生成标准正态分布的随机坐标;比较表达式生成布尔标签,.long() 转为类别编号。randperm 生成不重复的随机索引,再将索引切成训练和测试两部分。我们用同一组索引同时取坐标与标签,因此配对关系不会被打乱。
数据生成与批次打乱分别使用显式的随机数生成器。多次比较学习率时,它们能保持相同的数据、初始化种子与批次顺序。固定种子有助于在相同环境中复现,但跨版本、跨设备仍可能存在差异。
run_experiment() 建立模型、损失函数和优化器,外层循环执行 40 个 epoch。每轮调用 train_epoch(),其内部循环处理所有批次。480 个训练样本、每批 32 个,所以每轮有 15 次参数更新,40 轮总共更新 600 次。
注意 loss_sum += loss.item() * len(inputs)。当前损失默认是这个批次的平均值,乘上实际批次大小后累加,最后除以样本总数,得到按样本加权的整轮均值。即使最后一批不足 32 个,统计方式仍适用。本例没有类别权重或忽略标签,采用这个计算即可。
训练过程中每个批次使用的参数都略有不同,因此记录的整轮损失是训练期间各批次损失的平均,不是用该轮结束后的最终模型重新评估整个训练集得到的损失。
evaluate() 把 120 个测试样本一次输入模型,计算损失和准确率。predictions == labels 得到布尔张量,.float().mean() 将它变成正确比例,.item() 再转为普通 Python 数值。如果数据很大,评估也应分批进行。
保存部分使用 state_dict() 获取模型参数和持久缓冲区的状态。加载时先创建相同结构的 Classifier,再装入状态;最后切换评估模式。保存和载入的进一步说明见 PyTorch 模型保存教程。
这里保存的文件足够用于重新预测。如果需要中断后继续训练,还应保存优化器状态、训练轮数以及相关随机状态等信息。本例没有实现完整的训练恢复。
torch.allclose(before, after) 检查保存前后的预测分数是否在允许误差内一致,呼应第 2 章的浮点比较问题。接着输出两个新点的预测类别,这两点又回到了第 3 章的例子。
9.7 实际运行结果
本文在 Python 3.14.3、PyTorch 2.11.0 的 CPU 环境中验证。NumPy 为 2.4.4,Matplotlib 为 3.10.9。这是验证时的版本记录,无需为了学习而强行升级到相同版本;安装时仍以各包支持的版本组合为准。
一次运行得到:
epoch=01, train_loss=0.5930
epoch=10, train_loss=0.2015
epoch=20, train_loss=0.1321
epoch=30, train_loss=0.1045
epoch=40, train_loss=0.0891
test_loss=0.0991, test_accuracy=100.0%
保存前后预测一致: True
新样本预测: [1, 0]
下面是同一次实验设置下重新运行生成的图。测试集的两种标记分别对应两个类别,虚线是生成标签时使用的分界线 x1 + x2 = 0。虚线由已知规则绘制,不表示模型的决策边界。
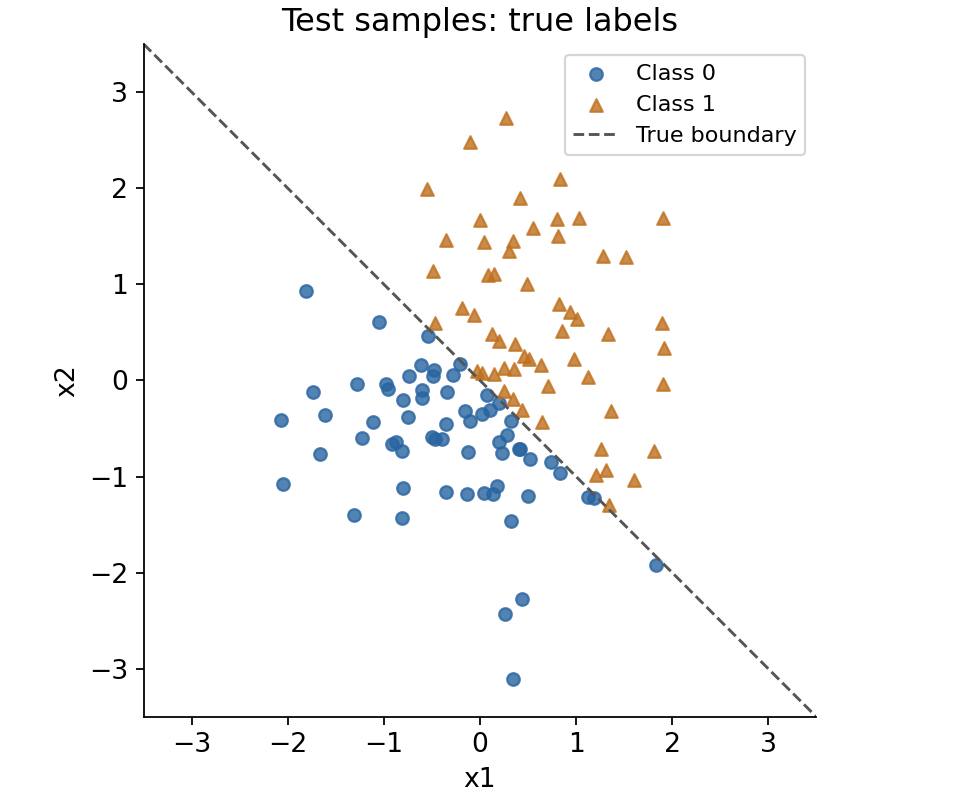
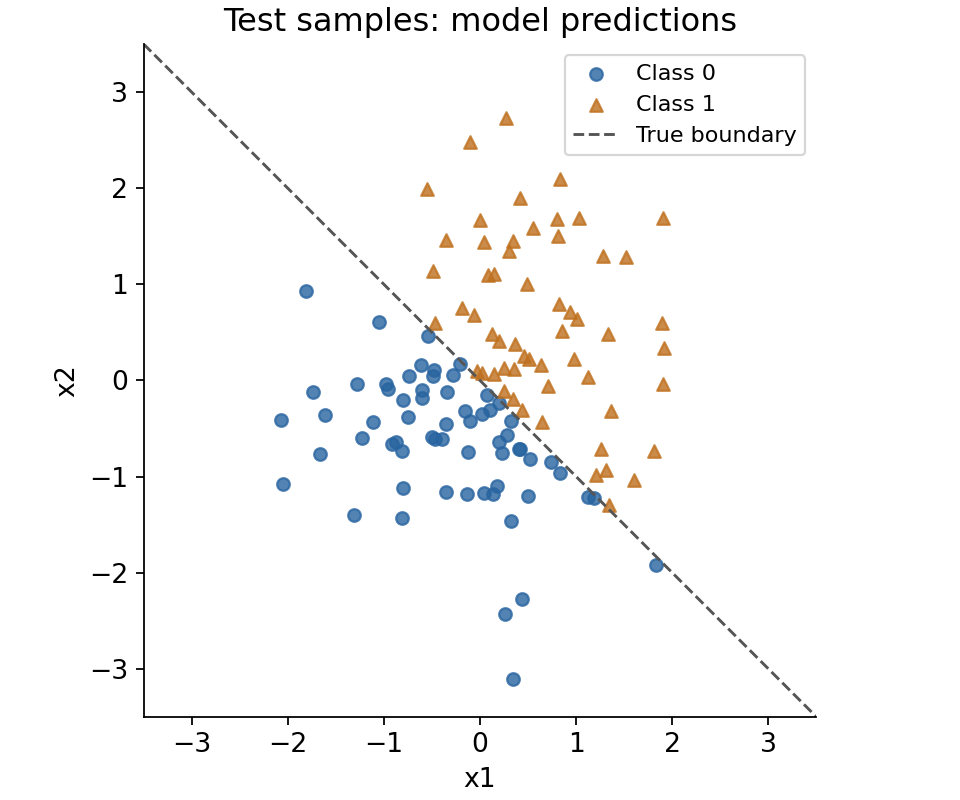
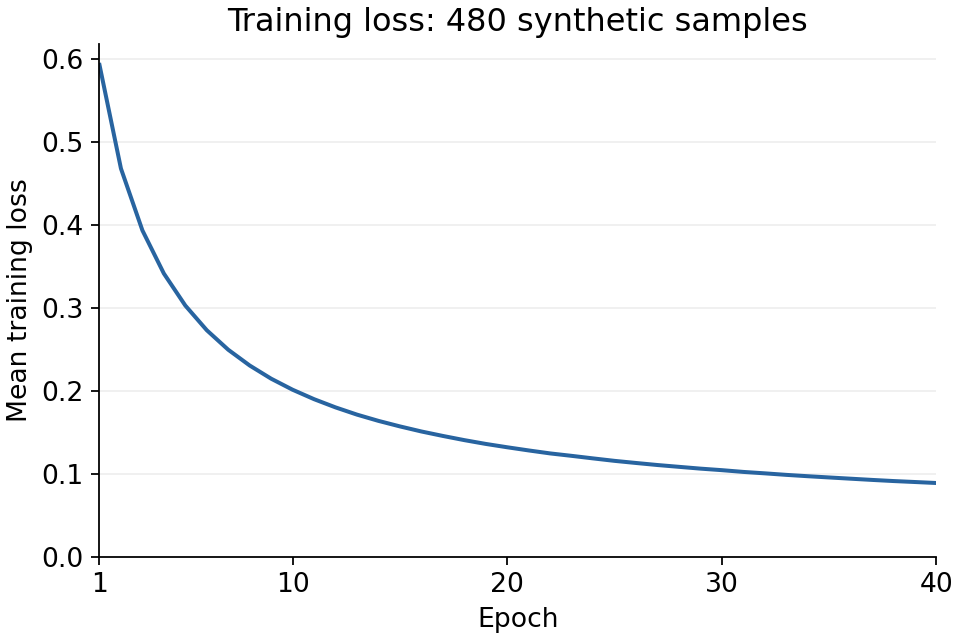
损失整体下降,说明训练过程逐渐降低了所定义的目标。测试准确率为 100%,表示这次划分的 120 个点恰好全部预测正确。换一批点,尤其加入更多靠近分界线的点,未必仍全部正确;不能由这次有限样本的结果推断模型在所有坐标上都与规则一致。
需要自己生成图片时,将绘图脚本与 train.py 放在同一目录,运行 python plot_results.py。图片保存到 outputs。图中文字使用英文,方便在没有中文字体的 Python 环境中复现;中文含义已在正文和图片说明中给出。
9.8 在 Notebook 中动手改一改
这篇文章附有一份可下载的 Jupyter Notebook。它按章节排列主要示例,包含训练代码和绘图代码,可以独立使用,无需另外下载 .py 文件。保存的输出可以直接查看,修改后重新执行单元格即可观察变化。
先在前面创建的环境中安装 Notebook 所需工具:
python -m pip install jupyterlab ipywidgets
python -m jupyterlab
在 JupyterLab 中打开下载的 .ipynb,选择这个环境对应的内核。执行第一段环境检查,核对解释器与 PyTorch 版本。Shift + Enter 运行当前单元格并移到下一格。
Notebook 包含两个可以调整参数的实验:
- 张量形状实验:改变行数、列数,查看第一列、保留列维度的切片、每行均值各有什么形状。界面同时显示实际张量,便于对照。
- 学习率实验:选择学习率和训练轮数,点击运行,观察训练损失曲线。每次使用相同的数据划分、初始化种子和批次顺序,便于比较本次改变的参数。
交互控件需要正在运行的 Python 内核和 ipywidgets 支持。普通静态预览可以看已保存的结果;若控件没有显示,直接修改对应函数的参数并运行也能完成实验。
比较学习率时,先记录 0.003、0.03、0.3 三个设置下的训练曲线,观察相同轮数内的下降速度与波动。测试集留到最后评估。若反复查看测试分数再挑选最好的设置,测试集就参与了选择过程;进一步做调参实验时,应从训练数据中另划验证集。
本章练习:先把隐藏层宽度从 16 改成 8,注意前后两层的尺寸都要修改。再尝试只用 nn.Linear(2, 2) 完成分类,比较训练速度和损失。这个任务的真实边界是直线,较小的模型也有能力表达它。最后为模型输入一个形状为 [2] 的新点,先用 unsqueeze(0) 显式加上批次维,再取出预测类别。
10. 练习核对与后续阅读
10.1 几道练习的参考写法
第 2 章,计算准确率并格式化:
sample_count = 80
correct = 62
accuracy = correct / sample_count
print(f"准确率:{accuracy:.1%}")  # 准确率:77.5%
第 3~4 章,取出坐标并找出预测错误的样本:
points = [[0.2, 0.7], [-0.8, -0.3], [0.6, -0.1]]
labels = [1, 0, 0]
x1, x2 = points[1]
print(x1, x2)   # -0.8 -0.3
print(points[:2])
for index, (point, target) in enumerate(zip(points, labels)):
    prediction = int(point[0] + point[1] > 0)
    if prediction != target:
        print(f"编号 {index}:预测 {prediction},标签 {target}")
应找到编号为 2 的样本。第 5 章的准确率函数完整答案见 7.4 节;它同时处理了长度不一致和空列表。
第 6 章,批次大小改为 3 后,五个数分为 [10, 20, 30]、[40, 50]。最后一批不会自动补齐。
第 8 章,逐行去均值:
import torch

x = torch.tensor([[1., 2.], [3., 4.], [5., 6.], [7., 8.]])
column = x[:, 0]
row_mean = x.mean(dim=1, keepdim=True)
centered = x - row_mean
one_point = x[0].unsqueeze(0)
print(column.shape)     # torch.Size([4])
print(row_mean.shape)   # torch.Size([4, 1])
print(centered.shape)   # torch.Size([4, 2])
print(one_point.shape)  # torch.Size([1, 2])
print(centered.mean(dim=1))  # tensor([0., 0., 0., 0.])
[4, 1] 与 [4] 广播时,后者可按 [1, 4] 比较,两维分别扩展成 4,所以结果是 [4, 4]。保留均值的列维度,就能让 [4, 2] - [4, 1] 按原本预期逐行相减。
10.2 再读训练代码时可以检查什么
重新打开 train.py,试着不看说明,回答下面几个问题:
PointDataset的一条数据包含什么?进入DataLoader后,尺寸怎样变化?Classifier的参数在哪里创建?model(inputs)怎样进入forward?- 为什么标签用
long,模型输入用float32? - 为什么要先清梯度,求导之后再更新参数?
- 评估时的模型模式与梯度记录分别在哪里设置?
- 为什么保存前后的结果用
allclose检查?
遇到答不出的地方,可以回到对应章节,只重跑那个最小例子。等这些问题清楚后,再读 PyTorch 官方完整入门流程,把二维点换成图像数据。届时新增的主要内容会是图像尺寸、预处理和更适合图像的模型结构。
想继续补 Python,可以按需要查官方教程中的模块、类、文件读写和异常章节。装饰器、上下文管理器的实现、命令行参数、测试,以及多进程加载,适合在遇到具体代码时继续学。把本篇的训练代码拆成数据、模型、训练三个模块,也是一次合适的后续练习。